Zwei häufige Fehler beim Verständnis von Sprints
Es gibt zwei Fehler beim Verständnis des Sprint-Konzepts (oder der Agile-Iteration), die ich ziemlich oft sehe. Wo immer sie auftreten, vernichten diese beiden Fehler den Nutzen des Sprints vollständig. Sie senken Transparenz und Vorhersagbarkeit der Lieferung und erzeugen unnötigen prozessualen Overhead. Die beiden häufigen Fehler sind:
- Den Sprint verlängern. Typisch, wenn ein Team hinter dem Plan liegt, aber trotzdem den gesamten geplanten Scope abschließen will, bevor es das Sprintende erklärt.
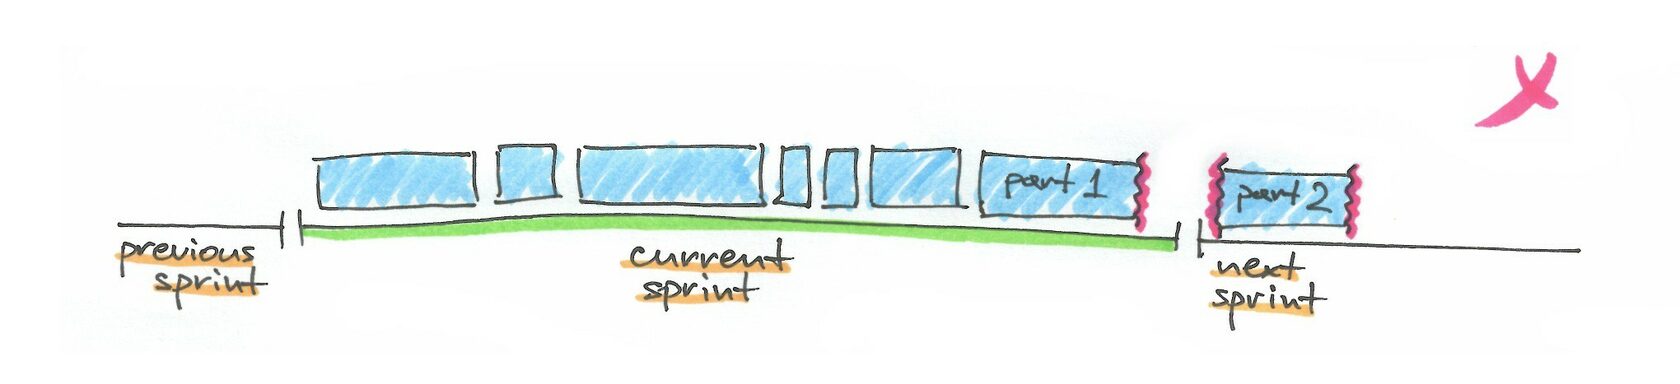
- (Digitale) Karten oder Tickets von einem Sprint in den nächsten klonen. Passiert, wenn am Sprintende unvollständige Work Items da sind und das Team sie statt Carry-over in Folgesprints klont. Die Originale werden geschlossen, als wären sie done.
Über die Jahre habe ich ein mentales Modell genutzt, das gegen diese Fehler hilft – und das möchte ich teilen.
Das Timebox-Konzept lässt sich bis in die späten 80er zurückverfolgen. Als Extreme Programming (als „Iteration“) und Scrum (als „Sprint“) es übernahmen, wurde es noch populärer und zentraler Teil von Applied Agile [1]. Die Kraft der Praxis liegt in der Idee: Statt am Scope zu kleben, muss ein Team so viel Wert wie möglich in begrenzter Zeit liefern. Dieser Kern wird oft übersehen. Schon der Name – Timebox – deutet an, wie man sie behandeln sollte: als Zeitspanne und als Eimer (eine „Box“) zugleich. Schauen wir, wie diese beiden Aspekte fehlinterpretiert werden und welches Denkwerkzeug hilft.
Fehler: Sprint verlängern, um den Scope unterzubringen
Ein Team hat 10 User Stories für einen Zweitwochen-Sprint geplant. Am letzten Tag sind 9 von 10 fertig, und das Team ist ziemlich sicher, dass die verbleibende Story etwa 2 Tage braucht. Das Team besteht auf einer Verlängerung. Sie beenden die Story schließlich in 4 Tagen – die tatsächliche Sprintdauer beträgt 14 Tage. Dasselbe wiederholt sich in den folgenden Sprints.
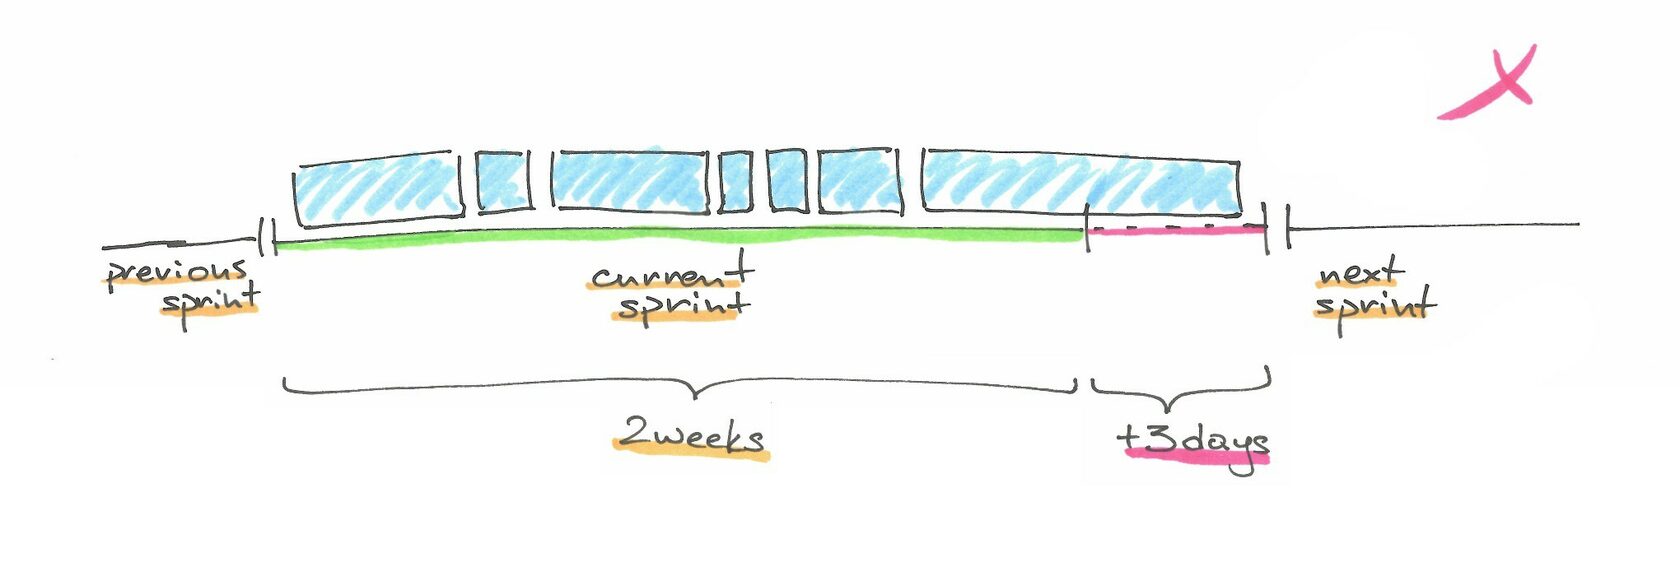
Terminverzüge sind in der Softwareentwicklung üblich – bis hin dazu, dass man sie als inhärent und unvermeidbar betrachten kann. Bei einem Verzug wollen Menschen intuitiv den Sprint verlängern, um den vollen geplanten Scope zu liefern. Ein Team – oder das Management oder der Product Owner – denkt, dass der Abschluss des vollen Scopes das Ende der Iteration definiert.
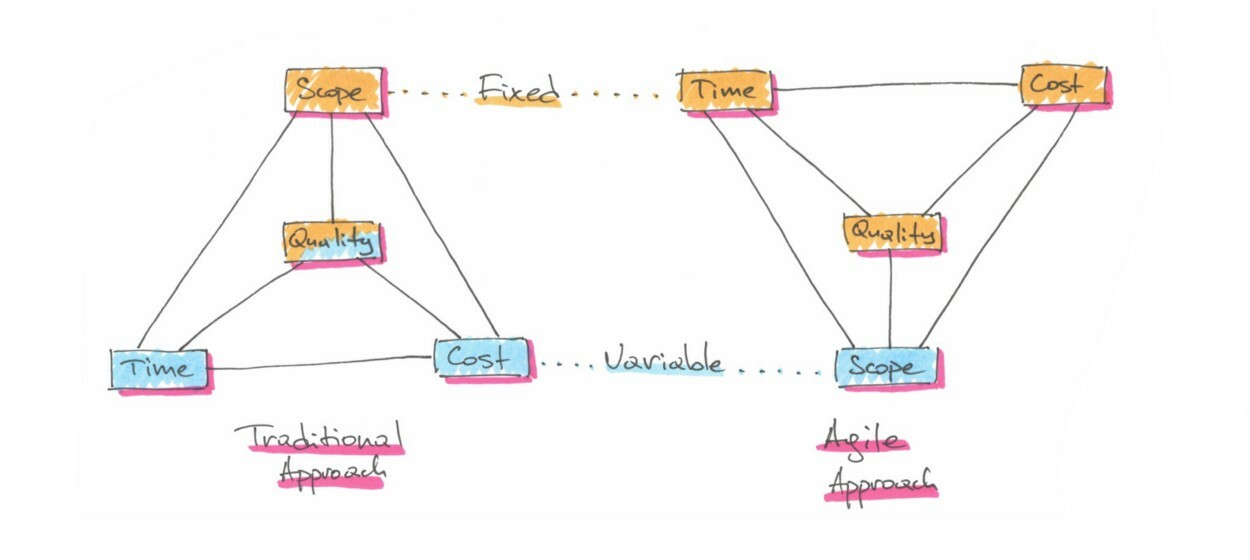
Dieser Fehler wurzelt im traditionellen Management, das um Scope-Commitments als primäres Steuerungsinstrument kreist. Sobald der Scope definiert und geschätzt ist, entsteht das Commitment, ihn zu liefern. Der Fokus liegt nun auf der Erfüllung – Scope vor dem geschätzten Deadline – und wenn das nicht geht, ist die einfachste Fix die Anpassung des Zeitplans. Ich vereinfache: Es gibt noch De-Scoping und Teamgröße. Dennoch gilt in diesem Paradigma der volle Scope als Baseline. Genau das versucht das Sprint-Konzept (Iteration/Timebox) umzukehren. Das illustriert das bekannte Diagramm:
Die negativen Effekte willkürlicher Iterationslängen sind dramatisch.
Erstens wird der Prozess chaotisch und bringt das Team aus dem Rhythmus. Aktivitäten, die regelmäßig und automatisch sein sollten, brauchen Fall-für-Fall-Scheduling. Unnötiger prozessualer Overhead. Das Team wird schnell müde und rutscht in Ad-hoc – und Ad-hoc heißt in der Praxis kein Prozess.
Zweitens wird jede Planung auf historischen Daten überkomplex und unzuverlässig. Eine der populärsten Metriken dafür in Agile Teams ist Velocity. Wie in der Physik die Distanz pro Zeiteinheit, ist es in der Softwareentwicklung die Arbeitsmenge pro Zeiteinheit (die Definition von „Arbeitsmenge“ kann variieren). Stellen Sie sich vor, Ihre Zeiteinheit ist variabel. Die Definition von Velocity ergibt keinen Sinn mehr.
Besser denken: Sprint ist eine Zeiteinheit
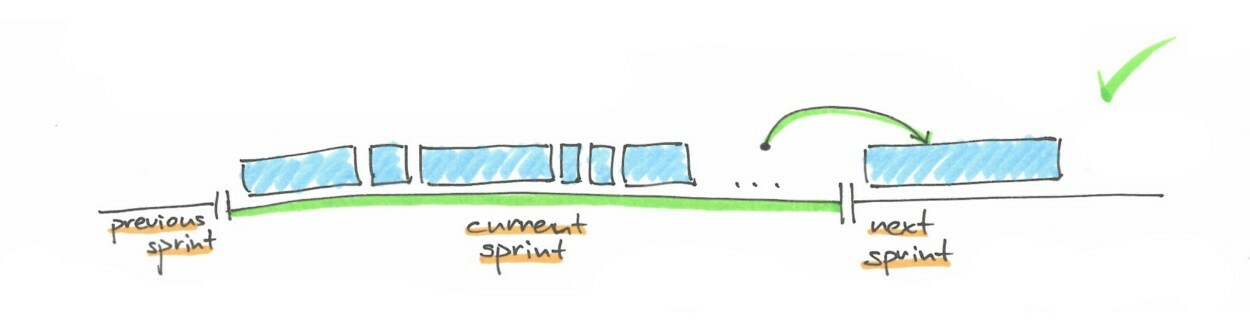
Nehmen wir eine astronomische Stunde. Sie können die Dauer einer Stunde nicht ändern – eine Stunde ist eine Stunde per Definition. So sollte man den Sprint betrachten. Alltag-Analogie: Wenn Sie einen Rasen mähen müssen, aber in einer Stunde nur die Hälfte geschafft haben, ist das Ihr Ergebnis – nicht mehr und nicht weniger. Sie können weiter mähen, aber die zusätzliche Arbeit fällt in die nächste Stunde. Sie verlängern die Stunde nicht. Stattdessen passen Sie Pläne und Prioritäten für die nächste Stunde an und überlegen, warum der erste Versuch nicht geklappt hat. Sie bekommen auch ein Verständnis Ihrer Velocity: 0,5 Rasen/Stunde. Genau das ist ein Sprint: die Zeiteinheit, nicht die Arbeitsmenge, die Sie dafür planen.
Fehler: Unvollständige Work Items klonen statt Carry-over
Ein Team hat den Sprint beendet, aber „User Story X“ ist noch nicht fertig. Das Team will den Fortschritt visualisieren. Auf dem Board gibt es eine Karte. Sie benennen sie in „User Story X Part 1“ um und verschieben sie nach Done. Sie erstellen „User Story X Part 2“ und legen sie in den nächsten Sprint. Auch dort schaffen sie die Story nicht. Also erstellen sie „User Story X Part 3“ und schieben „Part 2“ nach Done. Die Übung wiederholt sich noch ein paar Mal.
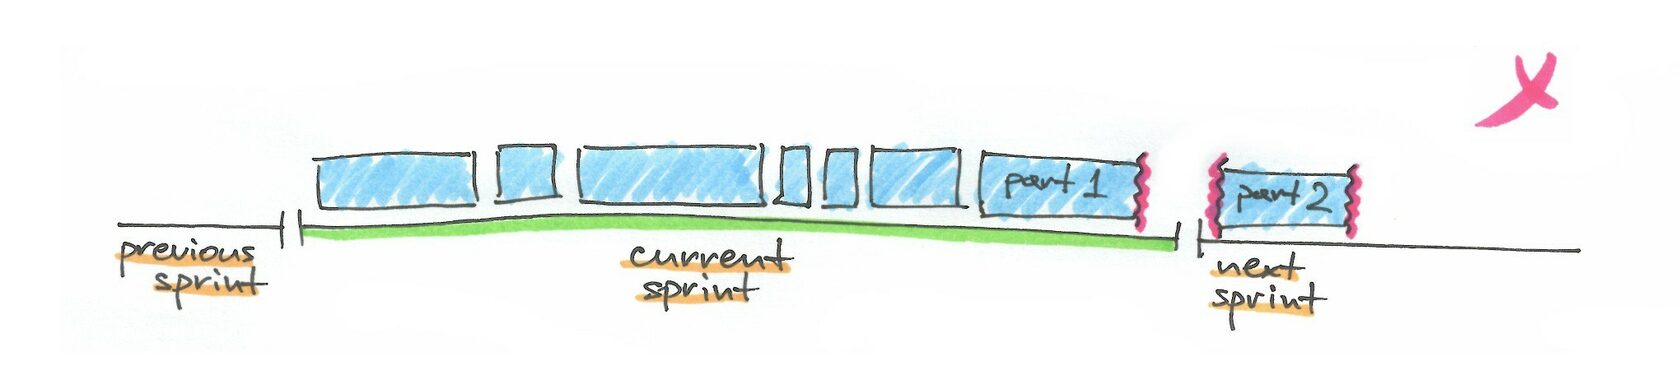
Das habe ich oft gesehen, meist bei digitalen Trackern (darunter das viel gescholtene Jira – überraschend, weil Jira den „richtigen“ Carry-over nativ unterstützt) – vermutlich weil Kopieren dort so billig ist. Schafft ein Team eine Story nicht, klont es sie in die nächste Iteration. Das Original wird „Part N“ und geschlossen, der Klon „Part N+1“.
Es gibt mehrere Gründe. Der offensichtlichste ist wohl der Wunsch, sich für geleistete Arbeit zu belohnen – sonst bleibt ein Gefühl von Ungerechtigkeit. Ein anderer typischer Grund: Cargo-Cult der goldenen Regel, eine User Story in einen Sprint zu pressen. Beides habe ich erlebt. Statt an der Ursache zu arbeiten, erzeugt das Team einfach ein künstliches Completed Item.
Dieses Tracking hat zahlreiche Probleme.
Erstens zeigt es nie echten Fortschritt. Ob eine User Story done ist, lässt sich nur mit dem ultimativen objektiven Kriterium bewerten – ist sie live oder nicht. In Scrum können Sie das über die Definition of Done stärken (oder schwächen). Das passt zu einem Agile-Prinzip: Working Software ist das primäre Maß für Fortschritt [3]. Eine Story wie im Beispiel zu zerteilen ist so unsinnig wie zu sagen: „Ich habe die Hälfte des Rasens gemäht, obwohl ich noch nicht weiß, wie groß er ist.“ Woher wissen Sie dann, dass es die Hälfte und nicht ein Viertel ist?
Zweitens nimmt solches Tracking den Anreiz, User Stories vertikal in kleinere Stücke zu schneiden. Es gibt keinen Druck auf eine Story, die man wirklich in einem Sprint abschließen kann – denn Sie haben 100 % Garantie auf ein Completed Item am Ende jedes Sprints.
Dann, in digitalen Tools, verwüstet es Ihre Daten. Es gibt keinen einfachen Weg, echte Lead Time oder echte Velocity zu berechnen, wenn Sie für dieselbe Arbeit laufend Entitäten hinzufügen. Die Item-Daten zeigen keine echten Zahlen – und für echte Zahlen müssen Sie aus mehreren Quellen aggregieren.
Und zuletzt verschwendet ständiges Klonen einfach Zeit. Ich habe Teams gesehen, die das gesamte Sprint Review nur damit verbrachten, neue Klone in TFS für den nächsten Sprint anzulegen.
Besser denken: Sprint ist ein Eimer
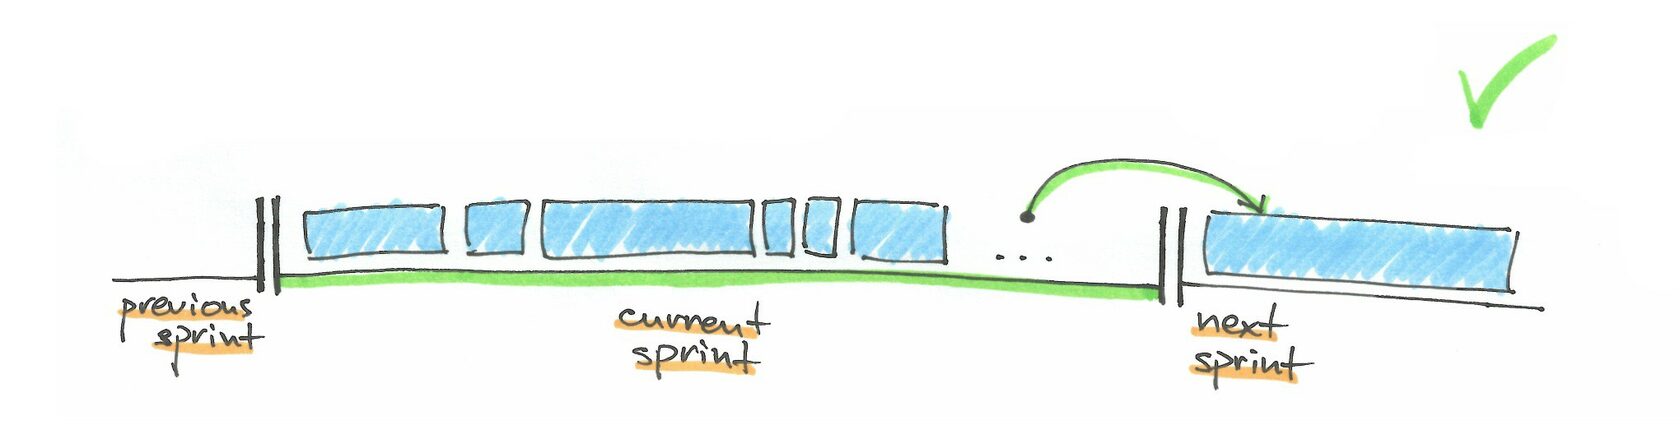
Denken Sie stattdessen an den Sprint als Eimer und an Work Items als Steine. In einen Eimer passen nur so viele Steine. Ein Work Item abschließen heißt, einen Stein aus dem Eimer zu nehmen. Am Sprintende schütten Sie alle Steine vom alten in einen neuen Eimer. Dasselbe gilt für Work Items: Sie werden unverändert in den nächsten Sprint-Backlog übernommen (und ohne Neuschätzung, wie Sie ahnen [4]).