Две частые ошибки в понимании спринта
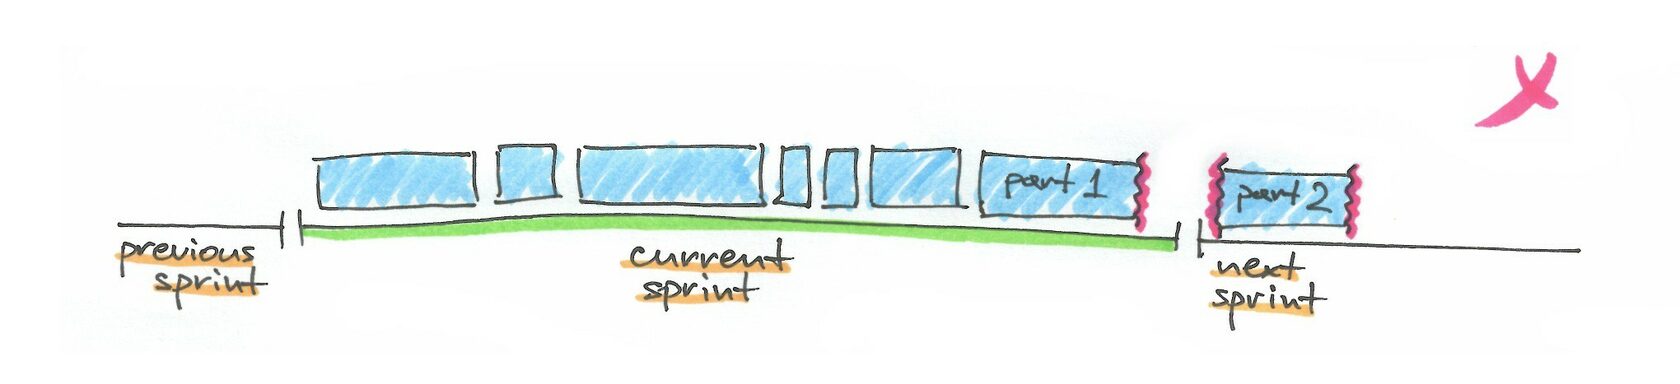
Есть две ошибки в понимании спринта (или Agile-итерации), которые я вижу довольно часто. Где бы они ни появлялись, они полностью сводят на нет пользу спринта. Снижают прозрачность и предсказуемость поставки и добавляют лишний процедурный overhead. Эти две частые ошибки:
- Удлинение спринта. Типично, когда команда отстаёт от графика, но всё равно хочет закрыть весь запланированный scope, прежде чем объявить конец спринта.
- Клонирование (цифровых) карточек или тикетов из спринта в спринт. Случается, когда в конце спринта есть незавершённые элементы, и команда клонирует их в следующие спринты вместо переноса. Оригиналы закрывают, как будто они done.
За годы у меня сложилась мысленная модель, которая помогает бороться с этими ошибками, — ею и поделюсь.
Концепцию timebox можно проследить ещё до конца 80-х. Когда её переняли Extreme Programming (как «iteration») и Scrum (как «sprint»), она стала ещё популярнее и необходимой частью applied Agile [1]. Сила практики — в идее: вместо фиксации на scope команда должна фокусироваться на поставке как можно большей ценности за ограниченное время. Но этот смысл часто упускают. Само название — timebox — подсказывает, как к нему относиться: и как к отрезку времени, и как к ведёрку (коробке) одновременно. Разберём, как эти два аспекта искажают и какой инструмент мышления помогает избежать искажения.
Ошибка: удлинять спринт под scope
Команда запланировала 10 user stories на двухнедельный спринт. В последний день 9 из 10 готовы, и команда почти уверена, что оставшаяся story займёт около 2 дней. Команда настаивает на продлении спринта. В итоге story заканчивают за 4 дня — фактическая длительность спринта 14 дней. То же повторяется в следующих спринтах.
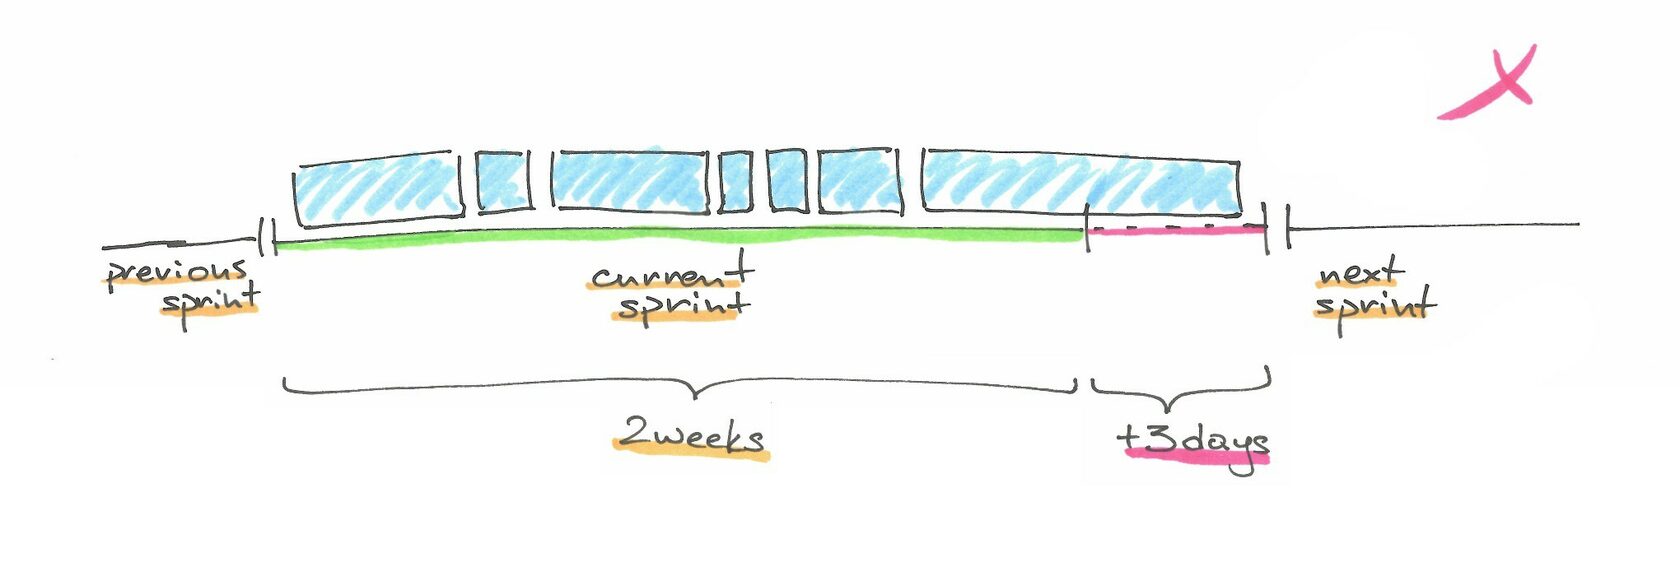
Срывы сроков в разработке софта — обычное дело. До такой степени, что их можно считать неизбежными. Когда срыв случается, люди интуитивно хотят продлить спринт, чтобы поставить весь запланированный scope. Команда — или менеджмент, или product owner — думают, что завершение полного scope определяет конец итерации.
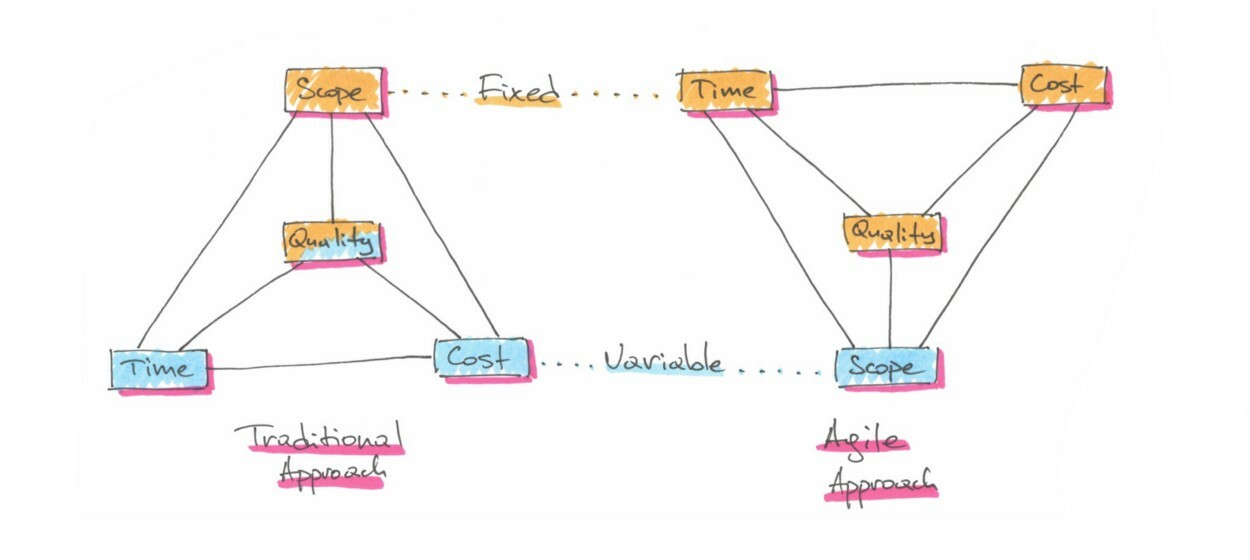
Корни ошибки — в традиционном менеджменте, где commitments по scope — главный инструмент контроля исполнения. Как только scope проекта определён и оценён, формируется commitment его поставить. Ключевой фокус — выполнить commitment, то есть поставить scope до дедлайна, а если нельзя — проще всего сдвинуть график. Я упрощаю: остаются варианты de-scoping и изменения размера команды. Тем не менее в этой парадигме полный scope — базовая линия, от которой отталкиваются. Именно это концепция спринта (итерации / timebox) пытается перевернуть. Это метко иллюстрирует известная диаграмма:
Негативные эффекты произвольного изменения длины итерации довольно сильны.
Во-первых, процесс превращается в хаос и сбивает команду с ритма. Активности, которые должны быть регулярными и автоматическими, теперь требуют планирования кейс за кейсом. Лишний процедурный overhead. Команда быстро устаёт и скатывается в ad-hoc процесс — а ad-hoc на практике значит отсутствие процесса.
Во-вторых, любое планирование на исторических данных становится слишком сложным и ненадёжным. Одна из самых популярных метрик для исторических данных в Agile — velocity. Как в физике это расстояние за единицу времени, в разработке софта — объём работы за единицу времени (определение «объёма» может отличаться). Представьте: единица времени переменная. Само определение velocity теряет смысл.
Думайте иначе: спринт — единица времени
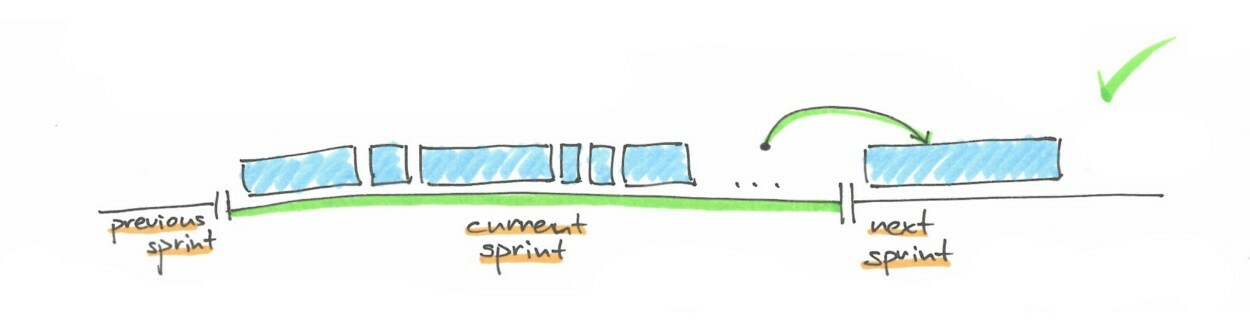
Возьмём астрономический час. Длительность часа не изменить — час есть час по определению. Спринт стоит воспринимать так же. Аналогия из жизни: нужно покосить газон, но за час успели половину — вот ваш результат, ни больше ни меньше. Можно продолжать косить, но вся дополнительная работа уже в следующем часе. Час не удлиняют. Вместо этого корректируют планы и приоритеты на следующий час и думают, почему не уложились с первой попытки. Также появляется понимание velocity: 0,5 газона/час. Вот что такое спринт. Это единица времени, а не объём работы, который на неё запланировали.
Ошибка: клонировать незавершённые элементы вместо переноса
Команда завершила спринт, но «User Story X» ещё не готова. Команда хочет визуализировать прогресс по story. На доске есть карточка. Её переименовывают в «User Story X Part 1» и переносят в Done. Создают «User Story X Part 2» и кладут в следующий спринт. В следующем спринте story тоже не заканчивают. Создают «User Story X Part 3» и переносят «Part 2» в Done. Упражнение повторяется ещё несколько раз.
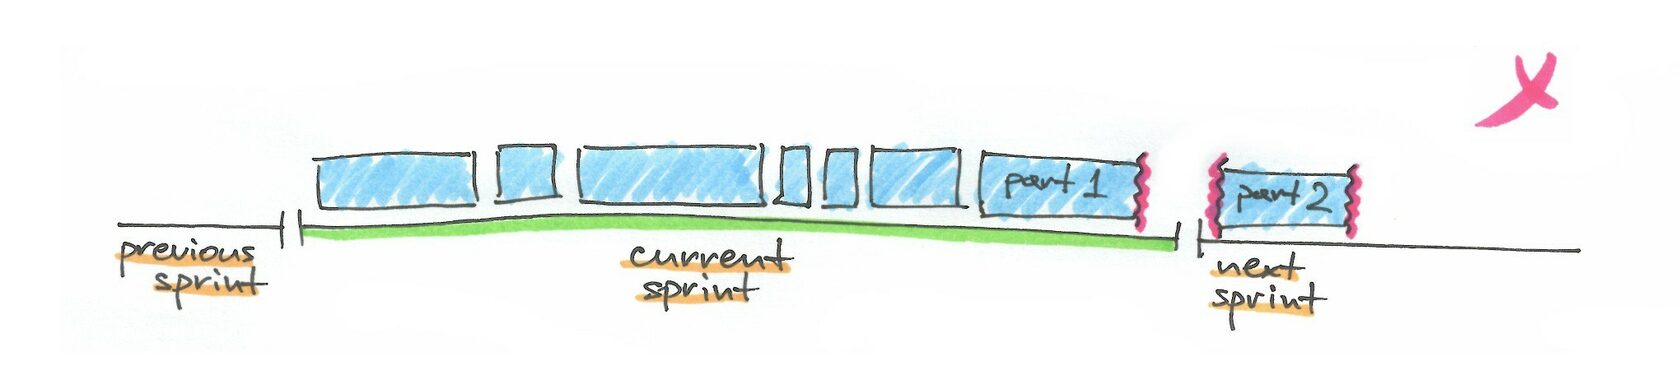
Это я видел часто, обычно в цифровых трекерах (в том числе в нелюбимой Jira — удивительно, ведь Jira нативно поддерживает «правильный» перенос) — вероятно, потому что копирование там дёшево. Когда story не успевают, её клонируют в следующую итерацию. Оригинал становится «part N» и закрывается, клон — «part N+1».
Причин несколько. Самая очевидная — желание наградить себя за выполненную работу, иначе остаётся ощущение несправедливости. Другая типичная — cargo-cult золотого правила «user story должна умещаться в один спринт». Я видел оба варианта. Вместо работы с корневой причиной команда просто создаёт искусственный completed item.
У такого трекинга много проблем.
Во-первых, он никогда не показывает реальный прогресс. Done ли user story — можно оценить только объективным критерием: live она или нет. В Scrum критерий усиливают (или ослабляют) через Definition of Done. Это согласуется с одним из Agile-принципов: работающий софт — главная мера прогресса [3]. Разрезая story на части, как в примере, вы делаете что-то столь же бессмысленное, как сказать: «Я покосил половину газона, хотя до сих пор не знаю, какой он большой». Откуда тогда знать, что это половина, а не четверть?
Во-вторых, такой трекинг снимает стимул вертикально нарезать user stories на более мелкие куски. Нет давления иметь story, которую реально можно завершить за спринт, — ведь 100% гарантия completed item в конце каждого спринта всё равно есть.
Далее, в цифровом инструменте это портит данные. Нет простого способа посчитать настоящий lead time или настоящую velocity, когда для одной и той же работы плодятся сущности. Данные по items не показывают правду, а чтобы её получить, нужно агрегировать из разных источников.
И наконец, постоянное клонирование просто тратит время на ненужные действия. Я видел команды, которые тратили весь sprint review только на создание новых клонов в TFS для следующего спринта.
Думайте иначе: спринт — ведро
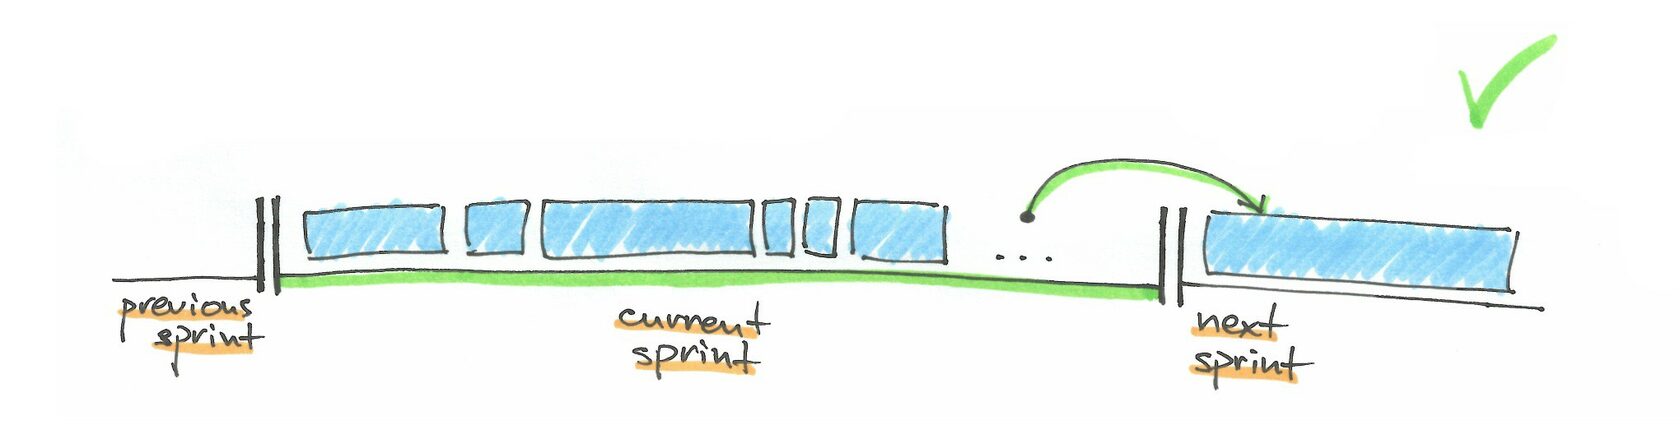
Думайте о спринте как о ведре, а о work items — как о камнях. В ведро помещается лишь столько камней. Завершить work item — значит вынуть камень из ведра. В конце спринта вы просто пересыпаете все камни из старого ведра в новое. То же с work items: они просто переносятся в бэклог следующего спринта без изменений (и без переоценки, как вы догадываетесь [4]).