Strategien für den Umgang mit ungeplanter Arbeit im Sprint
„Wie gehe ich mit ungeplanter Arbeit um?“ – diese Frage höre ich oft von den Teams, die ich schule oder coache. Die Antwort ist nicht so einfach, wie sie scheint. Zunächst muss man verstehen, dass ungeplante Arbeit selten für sich genommen das Problem ist. Meist ist sie nur ein Symptom der eigentlichen Ursachen, die im Verborgenen liegen. Entscheidend ist herauszufinden, was die ungeplante Arbeit verursacht. Erst dann können wir die Ursache aus dem richtigen Blickwinkel angehen. Oder wir lassen es ganz sein und lernen, damit zu leben (überraschenderweise ist das in vielen Fällen die vernünftigste Option). In diesem Artikel betrachten wir verschiedene Strategien, mit denen ein Team ungeplante Arbeit handhaben kann.
Der Leitfaden lässt sich auf jeden iterativen Entwicklungsprozess anwenden. Der Einfachheit halber verwende ich aber die Scrum-Terminologie. Schließlich ist Scrum laut „State of Agile“ die am weitesten verbreitete agile Methode. Aus demselben Grund benutze ich in diesem Artikel die Begriffe „User Stories“ und „Velocity“.
Sofortmaßnahmen und schnelle Lösungen
Die Strategien dieser Gruppe helfen, den Fluss des Teams schnell und mit geringen Kosten zu stabilisieren. Sie beheben nicht die zugrunde liegenden Probleme, aber oft reicht das völlig aus. Manchmal sollte man nach einer schnellen Lösung dennoch nach einer tragfähigeren suchen.
1. Absorbieren
Beispiel 1.1. Ein Team ist zur Hälfte durch den Sprint. Plötzlich meldet ein Nutzer einen Fehler in einem kürzlich veröffentlichten Feature. Er ist weder besonders groß noch besonders klein. Man hat das Gefühl, dass er im Product Backlog untergeht, wenn er nicht sofort behoben wird. Der Product Owner bittet das Entwicklungsteam, den Fehler zu beheben, sobald jemand frei wird.
Beispiel 1.2. Ein Team schließt eine User Story ab und zeigt sie den Stakeholdern, um schnell Feedback zu bekommen. Es stellt sich heraus, dass beim Refinement der Story vor Beginn der Umsetzung einige wichtige Details übersehen wurden. Dadurch entspricht sie nicht genau den Erwartungen. Die Stakeholder bitten das Team, den fehlenden Teil zu ergänzen, bevor die Story abgeschlossen wird.
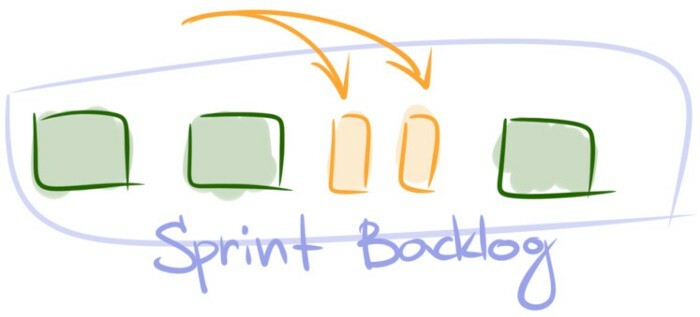
Was tun. Das Team die neue Arbeit absorbieren lassen.
Wann anwenden. Unsicherheit gehört zur Softwareentwicklung. Der Hauptgrund für frühe Demos ist, kleinere Unstimmigkeiten wie in Beispiel 1.2 früh zu erkennen, damit ihre Behebung weniger kostet. Und wenn ein Team agil arbeitet, sollte es bereit sein, die Chance zu nutzen, frühes Feedback zum eigenen Vorteil einzusetzen (wie eines der agilen Prinzipien es sagt). Agile lehrt außerdem: Wenn sich ein Team damit wohlfühlt, ist kein zusätzlicher Prozess nötig. Es kann viel einfacher sein, den Fehler aus Beispiel 1.1 zu beheben, als eine Verhandlung zu beginnen und ihn im Product Backlog zu priorisieren. Solange die neue Arbeit klein genug ist oder das Team den zusätzlichen Umfang bewältigen kann, ohne das Sprintziel zu gefährden, sind keine besonderen Maßnahmen nötig.
Geltungsbereich. Sprint.
Art der Maßnahme. Nicht-Handeln.
Kosten und Risiken. Ein Team liefert möglicherweise nicht alles, was für den Sprint geplant war. Auf lange Sicht sollte das aber kein Problem sein. Nutzt ein Team historische Daten zur Planung künftiger Sprints, sammeln sich darin schnell Informationen über absorbierte Arbeit an. Einfach gesagt: Die Velocity sinkt ein wenig und stabilisiert sich auf einem neuen, etwas niedrigeren Niveau. Die Planung berücksichtigt das automatisch, und nach ein paar Sprints ist das Absorbieren kein Thema mehr.
2. Aufteilen und übertragen
Beispiel 2.1. Wie in Beispiel 1.2 schließt ein Team eine User Story ab und zeigt sie den Stakeholdern. Diesmal stellt sich heraus, dass der Story ein großer Teil der Funktionalität fehlt, der für das Release entscheidend ist. Wieder bitten die Stakeholder das Team, den fehlenden Teil umzusetzen.
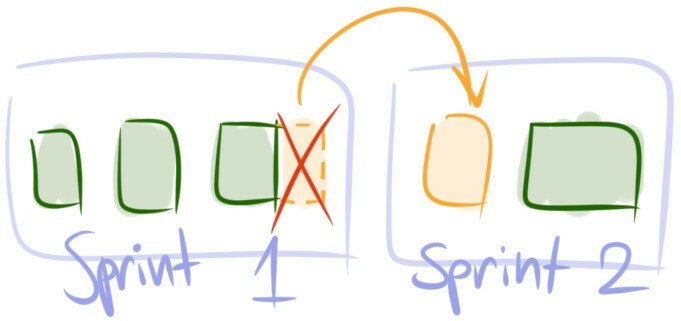
Was tun. Die ursprüngliche User Story wie in der Planung vereinbart abschließen. Alle zusätzlichen Anforderungen in eine neue User Story auslagern und für die kommenden Sprints einplanen.
Wann anwenden. Ist die neue Arbeit so groß wie eine durchschnittliche User Story, sollte daraus ein neuer Backlog-Eintrag werden. Ein zentrales Konzept hinter dem Sprint ist, dem Team zu ermöglichen, sich auf die Arbeit zu fokussieren. Ausreichend große Änderungen können und werden den Fluss des Teams stören. Der andere Grund ist, lokales Scope Creep zu verhindern. Eine User Story sollte auf ihr Ziel fokussiert bleiben (den „Ich möchte“-Teil). Werden ihr weitere Anforderungen hinzugefügt, besteht immer das Risiko, sie so aufzublähen, dass sie nie – nicht einmal teilweise – fertig wird. Deshalb ist es hier besser, die Arbeit in den nächsten Sprint zu übertragen.
Geltungsbereich. Der aktuelle und die nächsten Sprints.
Art der Maßnahme. Sofortmaßnahme.
Kosten und Risiken. Der große Umfang der neuen Anforderungen bedeutet wahrscheinlich, dass der neue Teil relativ wichtig ist und das Release der ursprünglichen Story allein für die Nutzer keinen Sinn mehr ergibt. Die Stakeholder werden nicht erfreut sein zu erfahren, dass das Release des gesamten gewünschten Features (ursprüngliche und neue Anforderungen) sich um einen Sprint verzögern kann. Zugleich kommt es nicht selten vor, dass sich eine neue User Story als weniger kritisch herausstellt, als sie zunächst schien. Dann kann sie problemlos noch ein paar Sprints warten. In jedem Fall ist es Aufgabe des Product Owners, bei den Stakeholdern die richtigen Erwartungen zu setzen.
3. Ersetzen
Beispiel 3.1. In der zweiten Woche eines Sprints melden Stakeholder einen kritischen Fehler. Es wird klar, dass die Behebung nicht einfach wird. Die Entwickler schätzen, dass sie beträchtlich Zeit brauchen wird. Aber das Team hat keine Wahl. Es beginnt, den Fehler zu beheben.
Beispiel 3.2. Mitten im Sprint kommt eine Product Ownerin mit einer Bitte zum Team. Sie hat festgestellt, dass ein neues Feature mit höchster Priorität fertiggestellt werden muss, und bittet darum, es in den Sprint aufzunehmen.
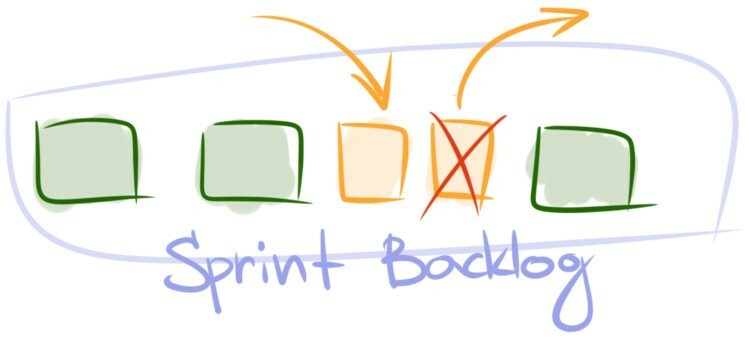
Was tun. Die neue User Story oder den Fehler in den Sprint aufnehmen. Dann entscheiden, welche andere Story oder Stories gleicher Größe geopfert werden können, und sie aus dem Sprint nehmen. Die entfernten Einträge können ganz oben im Backlog landen oder gleich für den nächsten Sprint eingeplant werden.
Wann anwenden. Die Anwendung dieser Strategie ist recht einfach. Wann immer ein ausreichend großes Stück Arbeit eingefügt werden muss, nimmt man etwas gleicher Größe aus dem Sprint. Man kann fragen, was „ausreichend groß“ ist. Der Product Owner kennt die Antwort nicht. Diese Entscheidung liegt in der Verantwortung des Entwicklungsteams.
Geltungsbereich. Der aktuelle und die nächsten Sprints.
Art der Maßnahme. Sofortmaßnahme.
Kosten und Risiken. Die ersetzte User Story wird offenbar nicht in dem Sprint geliefert, für den sie geplant war. Wie bei Aufteilen und übertragen kann zusätzliches Stakeholder-Management nötig sein.
4. Puffer einplanen
Beispiel 4.1. Ein Team hat einen Sprint geplant und mit der Entwicklung begonnen. Nach ein paar Tagen meldet ein Nutzer einen Fehler mit hoher Priorität. Das Team ersetzt eine geplante User Story durch den Fehler und macht weiter. Einige Tage später werden weitere Fehler gefunden. Die Situation wiederholt sich mehrfach, und ein großer Teil des Sprint Backlogs bleibt am Ende ungeliefert. In der nächsten Retrospektive stellt das Team fest, dass es schon seit mehreren Sprints so läuft.
Beispiel 4.2. Ein Team ist seit langer Zeit für ein Backend-System verantwortlich und zum Kompetenzzentrum für alle Backend-Fragen geworden. Wenig überraschend wird das Team gleich zu Beginn jedes neuen Sprints von anderen Teams mit Hilfeanfragen bombardiert.
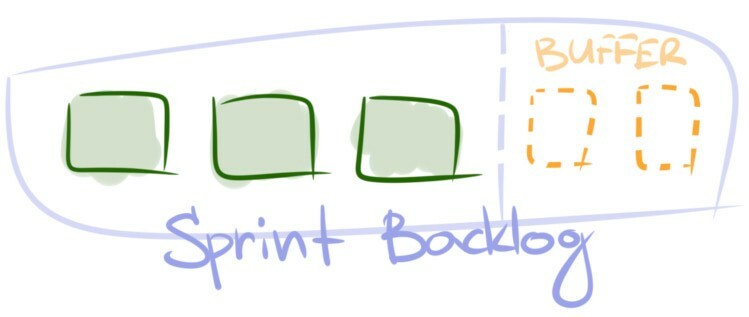
Was tun. In der Sprint-Planung einen Puffer im Sprint Backlog reservieren. Dafür gibt es zwei Wege. Erstens kann man einen virtuellen Backlog-Eintrag einer bestimmten Größe einplanen, der auf die Velocity angerechnet wird. Das ist der Puffer. Jedes Mal, wenn eine neue User Story oder ein Fehler in den Sprint kommt, zieht man ihre Größe vom Puffer-Eintrag ab, bis er null erreicht. Ab diesem Punkt lehnt das Team alle neue Arbeit ab und legt sie ins Product Backlog. Zweitens kann man einfach weniger Einträge einplanen, als es der üblichen Sprint-Velocity entspricht. Während des Sprints absorbiert man neue User Stories. Die Differenz zwischen durchschnittlicher und prognostizierter Velocity wirkt dann als impliziter Puffer.
Wann anwenden. Ein Puffer lohnt sich, wenn die Situation sich wiederholt, ungeplante Arbeit grundsätzlich unvermeidbar ist und die ungeplanten Stories umfangreich sind. Mögliche Beispiele: Das Team verfügt über einzigartige Expertise und muss andere Teams beraten; Marktschwankungen erschweren verlässliche Prognosen schon für ein paar Wochen. Als Faustregel gilt: Der Puffer sollte nicht mehr als 20–30 % der Velocity des Teams einnehmen, und gleichzeitig sollten die Sprintziele erreichbar bleiben.
Geltungsbereich. Produktlebenszyklus.
Art der Maßnahme. Schnelle Lösung. Übergangslösung.
Kosten und Risiken. Offensichtlich sinkt die Lieferrate der Roadmap-Einträge proportional zur Puffergröße. Das muss an sich kein Problem sein, hat aber eine Schattenseite. Unerwartete Arbeit entsteht oft aus organisatorischen oder technischen Ineffizienzen wie teamübergreifenden Abhängigkeiten, Legacy-Code oder geringer Produktqualität. Mit Puffern verschwenden wir faktisch bis zu einem Drittel der eigenen Zeit für Feuerlöschen, statt Wert zu schaffen und echte Probleme zu beheben. Deshalb sollten Sie diese Strategie immer als schnelle Lösung betrachten. Ein weiterer Grund zur Vorsicht: Puffer sind schwer zu pflegen, besonders wenn man ihre Größe plant. Die Planung der Puffergröße beruht auf der stillschweigenden Annahme, dass ein Team die Nachfrage steuern kann, sobald der Puffer auf null sinkt. In der Realität habe ich nie ein Team erlebt, das den Druck dringender ungeplanter Arbeit wirksam steuern konnte, nachdem der Puffer aufgebraucht war. Statt nur einer stark schwankenden Größe – der Sprint-Velocity – müssen Sie nun zwei prognostizieren. Deshalb ist Ersetzen als Sofortmaßnahme in vielen Fällen die bessere Wahl. Wer aber eine langfristige Lösung anstrebt, sollte immer nach Möglichkeiten suchen, die Maßnahmen zur kontinuierlichen Verbesserung aus der folgenden Liste anzuwenden.
Maßnahmen zur kontinuierlichen Verbesserung
Die Strategien dieser Gruppe erfordern erheblichen Aufwand und viel Zeit, bis sie Wirkung zeigen. Sie zielen auf grundlegende Fehlfunktionen im Entwicklungsprozess des Teams. Gemeinsam ist ihnen, dass sie am besten passen, wenn die ungeplante Arbeit erheblich ist, die Situation sich wiederholt, den Fluss des Teams ständig stört und die Sprint-Durchführung behindert.
5. Priorisierung verbessern
Beispiel 5.1. Ein Team schließt eine Sprint-Planung ab. Drei Tage nach Sprintbeginn kommt die Product Ownerin plötzlich mit einer ganzen Reihe neuer User Stories. Sie sagt, die Prioritäten hätten sich unerwartet geändert. Am Ende des Sprints stellt das Team fest, dass es nichts zu liefern hat.
Beispiel 5.2. Ein paar Tage nach Sprintbeginn bittet ein Product Owner darum, eine User Story in den Sprint aufzunehmen. Ein Stakeholder wünscht sie dringend umgesetzt. Ein paar Tage später kommt der Product Owner mit einer ähnlichen Bitte. Diesmal ist es ein anderer Stakeholder, aber die Story ist genauso dringend wie die erste. Das wiederholt sich mehrmals im Sprint. Das Ergebnis überrascht nicht: Am Ende des Sprints hat das Team nur die Hälfte seiner üblichen Velocity geschafft.
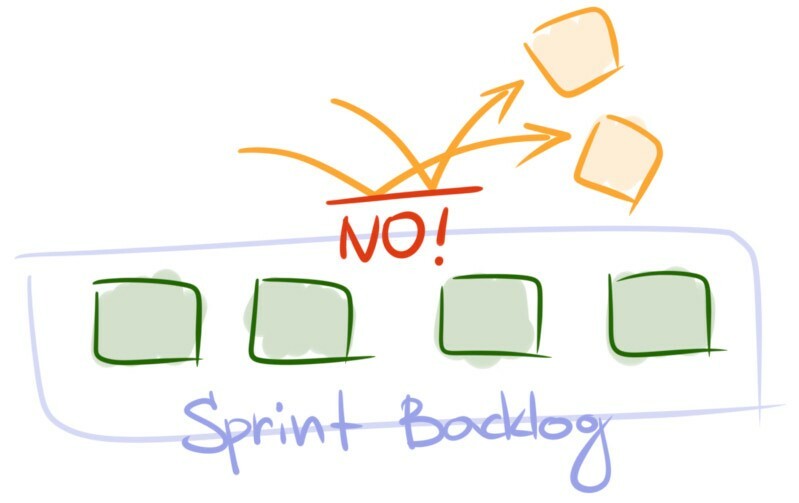
Was tun. Mit dem Product Owner arbeiten, damit er lernt, „Nein“ zu sagen. Mit den Stakeholdern arbeiten, um die richtigen Erwartungen an die Lieferung zu setzen. Erklären, dass das Team dringende Einträge nur gelegentlich annehmen kann. Falls nötig, vereinbaren, was „dringend“ bedeutet und wie häufig das Team solche Einträge bewältigen kann.
Wann anwenden. Die Beispiele können unterschiedlich sein, gemeinsam ist ihnen aber, dass sie fast ausschließlich vom Product Owner oder von Stakeholdern kommen. Nach der Fertigstellung liegen die neuen Einträge dann oft brach und warten auf etwas anderes, zum Beispiel darauf, dass ein anderes Team seine User Stories fertigstellt, damit ein größeres Feature marktfähig wird. In der Realität sind neue Einträge meist nicht so dringend und können problemlos bis zum nächsten Sprint warten.
Geltungsbereich. Produktlebenszyklus.
Art der Maßnahme. Ursache beheben.
Kosten und Risiken. Erfordert Coaching des Product Owners und Verhandlungen mit den Stakeholdern. Das kann eine anspruchsvolle Aufgabe sein. Da es um eine Verhaltensänderung geht, sollten Sie keine schnellen Ergebnisse erwarten.
6. Qualität verbessern
Beispiel 6.1. Ein Team erhält während eines Sprints zahlreiche Fehlermeldungen. Viele davon scheinen kritisch zu sein und müssen sofort behoben werden. In einer Retrospektive erkennt das Team, dass sich das über mehrere Sprints hinweg immer wieder wiederholt hat. Fehler sind zu einem großen Ärgernis geworden. Sie stören den Fluss des Teams und beeinträchtigen die Lieferung. Das lässt sich an Burn-down- und Velocity-Diagrammen deutlich ablesen. Die Sprints fühlen sich chaotisch an. Das Team verliert das Gefühl der Kontrolle über das, was es tut.
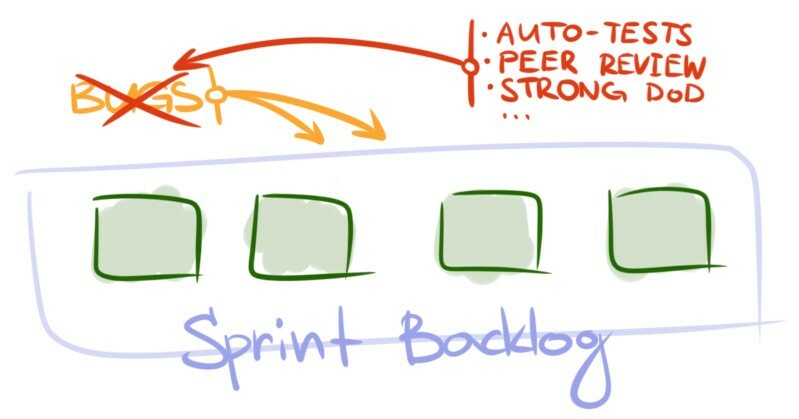
Was tun. Die Ursachen für die geringe Qualität analysieren (zum Beispiel mit Causal Loop Diagrams). Steht das Team zu stark unter Druck durch das Business und spart bei jeder Gelegenheit, um Fristen zu halten? Bieten die automatisierten Tests nicht genug Abdeckung? Oder gibt es ein Infrastrukturproblem, das die Anwendung hin und wieder abstürzen lässt? Sobald die Quellen identifiziert sind, Zeit investieren, sie zu beseitigen. Verschiedene Strategien ausprobieren. Höchstwahrscheinlich gibt es nicht die eine Fehlerquelle, und man braucht unterschiedliche Ansätze, um das Problem zu beheben.
Wann anwenden. Es ist nicht schwer zu erkennen, wann die Qualität der Schuldige ist. Kritische Fehler tauchen im Sprint immer häufiger auf. Sie unterbrechen den Fluss und machen das Sprintziel fast unerreichbar.
Geltungsbereich. Produktlebenszyklus.
Art der Maßnahme. Ursache beheben.
Kosten und Risiken. Die Quelle der Defekte zu finden, ist womöglich nicht einfach. Noch schwieriger ist es, Abhilfemaßnahmen umzusetzen. Beobachtet ein Team einen Zustrom an Defekten, der massiv genug ist, um den Fluss zu stören, hat es bereits genug Zeit gegeben, dass sich die negativen Folgen schlechter Entscheidungen ansammeln. Es braucht erheblichen Aufwand, die Situation umzukehren. Das verlangsamt die Lieferung, manchmal dramatisch. An diesem Punkt muss das Team einen Kompromiss eingehen. Wollen sie das Problem beheben und das Produkt auf Kosten der Velocity wieder in einen wartbaren Zustand bringen? Oder gehen sie das Risiko ein und hoffen, die Defekte bis zum Ende des Produktlebenszyklus in Schach halten zu können? Wählt ein Team die zweite Option, muss es auf Puffer einplanen zurückgreifen. Bedenken Sie aber: Die Verlangsamung durch schlechte Qualität kann die Verlangsamung durch deren Behebung viel früher überholen als erwartet.
7. Abhängigkeit beseitigen
Beispiel 7.1. Wie in Beispiel 4.2 besitzt ein Expertenteam ein Backend-System. Ein nachgelagertes Team hat kürzlich begonnen, einen neuen Microservice zu entwickeln, der das Backend als Datenquelle nutzt. Bald stellt es fest, dass dem Backend viele benötigte Daten fehlen. Anfragen nach einem weiteren Endpunkt oder einem weiteren Feld in einer Entität werden zu häufig und beginnen, das Expertenteam spürbar abzulenken.
Beispiel 7.2. Ein Team ist für die Infrastruktur des Systems verantwortlich. Es wird ständig von anderen Teams unterbrochen. Eine typische Anfrage: die Einstellungen eines Subsystems aktualisieren und die Anwendung neu bauen. Solche Aufgaben sind recht einfach, aber zeitaufwendig, und es gibt viele davon.
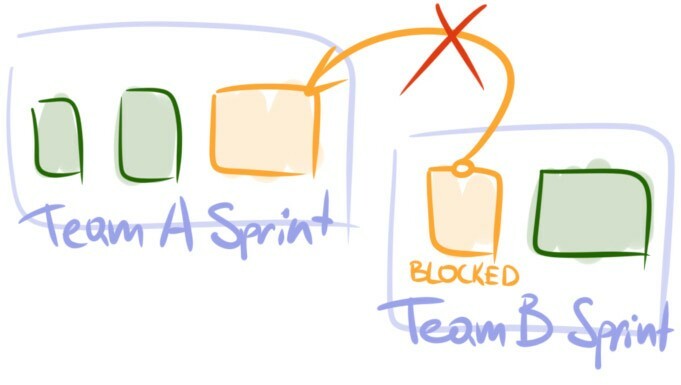
Was tun. Erstens: Das abhängige Team soll seinen Arbeitsbereich so weit wie möglich selbst verantworten. Geben Sie ihm alle nötigen Berechtigungen und Zugriff auf die gemeinsame Codebasis. Delegieren Sie Verantwortung und Entscheidungen. Zum Beispiel: Lassen Sie es das Subsystem, das es betreut, selbst deployen, statt dieses Recht einem eigenen Infrastrukturteam vorzubehalten. Schulen Sie die Leute darin, in der gemeinsamen Codebasis zu entwickeln und die delegierten Aufgaben zu übernehmen. Richten Sie einen Code-Review-Prozess ein, um Qualitätseinbußen zu vermeiden. Ein Entwickler aus dem Expertenteam kann zeitweise zum abhängigen Team wechseln, um dessen Expertise schnell zu stärken und teamübergreifende Code-Reviews weniger nötig zu machen. Zweitens: Suchen Sie nach technischen Wegen, die Abhängigkeit zwischen den beiden Teams zu kappen. Ohne sie sind viele der genannten Schritte nicht möglich. Schon die Entkopplung der Subsysteme kann den Teams helfen, unabhängiger zu werden. Zum Beispiel könnte das abhängige Team in Beispiel 7.2 einige Build-Time-Einstellungen in die Laufzeit verlagern. Dann kann es die Einstellungen der Anwendung selbst feinjustieren, ohne ein Infrastrukturteam einzubinden.
Wann anwenden. Wie der Name sagt, passt diese Strategie, wenn die ungeplante Arbeit in Form von Anfragen eines nachgelagerten Teams eintrifft. Typischerweise blockieren diese Anfragen das Team, das sie stellt.
Geltungsbereich. Produktlebenszyklus.
Art der Maßnahme. Ursache beheben.
Kosten und Risiken. Beide Teams müssen Aufwand betreiben, um die Abhängigkeit zu beseitigen. Dazu gehören Wissenstransfer-Sessions und Schulungen, das Einarbeiten in die neue Codebasis und die Umsetzung technischer Verbesserungen. Auch der Wechsel eines Teammitglieds von einem Team ins andere braucht Zeit, bis sich beide Teams an die neue Konstellation gewöhnt haben. Das kann die Velocity beider Teams beeinflussen. Da jede Änderung der Teamstruktur den Neuformierungsprozess auslösen kann, besteht außerdem stets das Risiko, einen Konflikt zu entfachen, der besondere Aufmerksamkeit erfordert.
8. Den Prozess anpassen
Beispiel 8.1. Ein Team wird während der Sprints ständig unterbrochen. Sprintziele werden dadurch hinfällig, und das Sprint Backlog wird mehrmals pro Sprint komplett umgebaut. Die ungeplante Arbeit kommt größtenteils vom Product Owner. Eine gründliche Analyse führt das Team zu der Erkenntnis, dass es nichts dagegen tun kann. Tatsache ist: Das Team entwickelt ein Produkt in einer jungen Branche mit hartem Wettbewerb. Ein kritisches Feature auch nur um ein paar Tage zu verzögern, kann das Unternehmen aus dem Geschäft drängen.
Beispiel 8.2. Ein Team arbeitet an einem langlebigen Produkt mit einer riesigen Legacy-Codebasis. Es hat jede bekannte gute Praxis ausprobiert und arbeitet hart an Verbesserungen. Trotz aller Anstrengungen machen die Menge an technischen Schulden und die Größe des Produkts es nahezu unmöglich, auch nur die kleinste User Story in einem Sprint abzuschließen. Das Problem liegt außerhalb der Reichweite des Teams. Es wurde mehrfach eskaliert, und eine eigene Initiative wurde gestartet, um es zu entschärfen. Erste positive Effekte sind bereits sichtbar, aber der Fortschritt ist zu langsam. Das Team erkennt, dass es sich nicht über Nacht bessern wird. Mit der gegebenen Lage muss es irgendwie zurechtkommen.
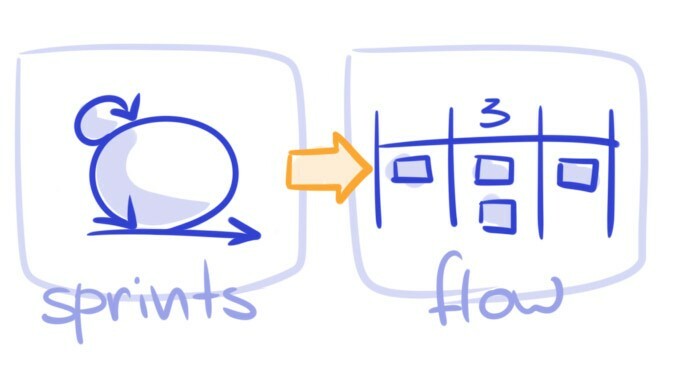
Was tun. Etwas anderes ausprobieren. Auf Iterationen verzichten und mit der Kanban-Methode arbeiten. Sprints sind nicht der einzige Weg, Entwicklung zu betreiben. Ergänzung: Wie in den Kommentaren vorgeschlagen, kann man auch kürzere Sprints probieren, bevor man voll auf Kanban umsteigt, oder eine eigene Lösung wählen. Allgemein: an den Prozess anpassen, der in Ihrem Kontext am besten passt.
Wann anwenden. Der Schwerpunkt dieser Strategie liegt darin, sich an die objektive Realität anzupassen. Sie sollten sie anwenden, wenn ungeplante Arbeit grundsätzlich unvermeidbar ist und von äußeren Bedingungen diktiert wird, auf die Sie keinen Einfluss haben. Doch es gibt einen Haken: Unter idealen Umständen sollten Sie Ihren Prozess nur ändern, wenn Sie sich entweder dem Markt anpassen oder Hebelwirkung auf den Markt gewinnen wollen. Im echten Leben gibt es immer eine Vielzahl von Faktoren, und die Entscheidung, den Prozess anzupassen, kann dennoch gerechtfertigt sein. Sie können diese Strategie in einer Situation wie in Beispiel 8.2 wählen. Sie sollten dabei aber wissen, dass es sich um eine vorübergehende Maßnahme handelt, die den Menschen unnötige Last abnimmt und Zeit verschafft, um echte Verbesserungen umzusetzen.
Geltungsbereich. Produktlebenszyklus oder befristet, je nach Ziel.
Art der Maßnahme. Ursache beheben.
Perspektive. Ursache umgehen.
Kosten und Risiken. Es hat einen Grund, dass diese Strategie zuletzt steht. Auch wenn sie für Sie die eigentliche Lösung sein mag, sollten Sie sie mit Vorsicht und aus tiefem Bewusstsein anwenden. Sie müssen absolut sicher sein, dass äußere Umstände die Veränderung erzwingen. Tappen Sie nicht in die Falle, eigene Probleme mit objektiven Umständen zu verwechseln. Bedenken Sie: Diese Strategie ist immer kostspielig und kann riskant sein, da sie ein Team in einen neuen Kontext versetzt und eine Neuformierung auslösen kann. Die Leistung des Teams wird höchstwahrscheinlich sinken, und es dauert, bis es sich an die neue Arbeitsweise gewöhnt hat. Bevor Sie also versuchen, den Prozess zu ändern, analysieren Sie die Situation gründlich und probieren Sie zuerst andere Strategien aus dieser Liste aus. Andernfalls laufen Sie Gefahr, bestehende Probleme nur zu verdecken, ohne das eigentliche Problem zu lösen.