Стратегии работы с незапланированными задачами в спринте
«Как справляться с незапланированной работой?» — вопрос, который я часто слышу от команд, которых обучаю или коучу. Ответ не так прост, как кажется. Прежде всего нужно понимать, что незапланированная работа редко бывает проблемой сама по себе. Обычно это лишь симптом настоящих проблем, скрытых от глаз. Важно понять, что именно порождает незапланированную работу. Только тогда мы сможем подойти к источнику проблемы с правильной стороны. Или вообще оставить всё как есть и научиться с этим жить (на удивление, во многих случаях это самый разумный вариант). В этой статье мы рассмотрим разные стратегии, которые команда может использовать для работы с незапланированными задачами.
Руководство применимо к любому итеративному процессу разработки, но для простоты я буду использовать терминологию Scrum. В конце концов, по данным «State of Agile», Scrum — самый распространённый agile-метод. По той же причине я буду говорить о «пользовательских историях» (user stories) и «скорости» (velocity).
Действия на месте и быстрые решения
Стратегии этой группы помогут быстро и недорого стабилизировать поток команды. Они не устраняют глубинные проблемы, но нередко этого вполне достаточно. Иногда, правда, после быстрого решения стоит поискать более надёжное.
1. Поглотить
Пример 1.1. Команда на середине спринта. Внезапно пользователь сообщает об ошибке в недавно выпущенной функции. Она не слишком большая, но и не слишком маленькая. Есть ощущение, что если не исправить её сразу, она затеряется в бэклоге продукта. Product Owner просит команду разработки исправить ошибку, как только кто-нибудь освободится.
Пример 1.2. Команда завершает пользовательскую историю и демонстрирует её стейкхолдерам, чтобы быстро получить обратную связь. Выясняется, что при проработке истории перед началом реализации были упущены важные детали. В итоге результат не совсем соответствует ожиданиям. Стейкхолдеры просят команду добавить недостающую часть до закрытия истории.
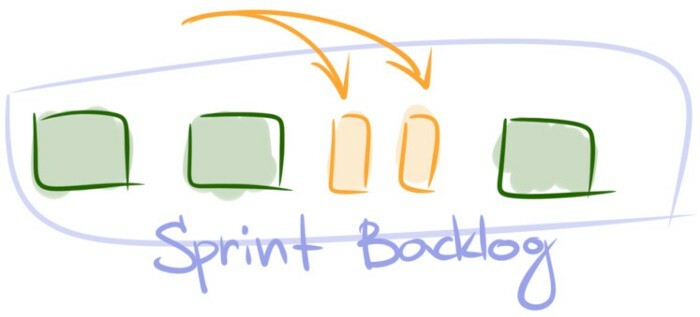
Что делать. Позволить команде поглотить новую работу.
Когда применять. Неопределённость свойственна самому процессу разработки ПО. Главная цель ранних демонстраций — выявлять небольшие несоответствия, как в примере 1.2, пораньше, чтобы их исправление обходилось дешевле. А команда, работающая по Agile, должна быть готова использовать ранний фидбэк себе на пользу (как говорится в одном из принципов Agile). Agile учит и другому: если команде комфортно, дополнительный процесс не нужен. Исправить ошибку из примера 1.1 может быть намного проще, чем начинать переговоры и приоритизировать её в бэклоге продукта. Поэтому, пока объём новой работы достаточно мал или команда справляется с ростом объёма, не ставя под угрозу цель спринта, никаких особых действий не требуется.
Область применения. Спринт.
Тип действия. Бездействие.
Затраты и риски. Команда может сделать не всё, что запланировала на спринт. Но в долгосрочной перспективе это не должно быть проблемой. Если команда использует исторические данные для планирования будущих спринтов, в них быстро накопится информация о поглощённой работе. Проще говоря, скорость немного упадёт и стабилизируется на новом, чуть более низком уровне. Планирование автоматически учтёт это, и через пару спринтов поглощение перестанет быть проблемой.
2. Разделить и перенести
Пример 2.1. Как и в примере 1.2, команда завершает пользовательскую историю и демонстрирует её стейкхолдерам. На этот раз выясняется, что в истории не хватает большого куска функциональности, критичного для релиза. Стейкхолдеры снова просят команду реализовать недостающую часть.
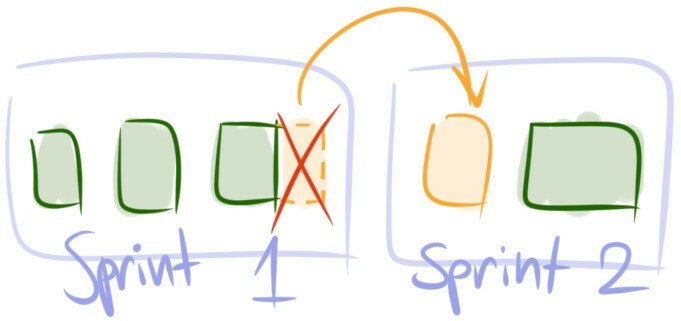
Что делать. Завершить исходную историю, как было согласовано на планировании. Выделить все дополнительные требования в новую историю и запланировать её на ближайшие спринты.
Когда применять. Если объём новой работы сопоставим с размером средней пользовательской истории, её нужно превратить в новый элемент бэклога. Одна из ключевых идей спринта — дать команде возможность сосредоточиться на работе. Достаточно крупные изменения могут и будут ломать поток команды. Другая причина — предотвратить локальное разрастание объёма. История должна оставаться сфокусированной на своей цели (части «я хочу»). Если добавлять к ней всё новые требования, всегда есть риск раздуть её так, что она никогда не будет завершена, даже частично. Поэтому перенос работы в следующий спринт здесь — лучший подход.
Область применения. Текущий и несколько следующих спринтов.
Тип действия. Действие на месте.
Затраты и риски. Большой объём новых требований, вероятно, означает, что новая часть довольно важна и выпускать только исходную историю уже не имеет смысла для конечного пользователя. Стейкхолдерам не понравится, что релиз всей нужной им функции (исходные и новые требования) может сдвинуться на спринт. При этом нередко новая история оказывается не такой критичной, как казалось на первый взгляд. Тогда она спокойно может подождать ещё несколько спринтов. В любом случае Product Owner отвечает за то, чтобы выстроить правильные ожидания у стейкхолдеров.
3. Заменить
Пример 3.1. На второй неделе спринта стейкхолдеры сообщают о критической ошибке. Становится ясно, что исправление будет непростым. Разработчики оценивают, что оно займёт немало времени. Но у команды нет выбора. Они начинают исправлять ошибку.
Пример 3.2. В середине спринта Product Owner приходит к команде с просьбой. Она обнаружила, что новую функцию нужно сделать с наивысшим приоритетом, и просит добавить её в спринт.
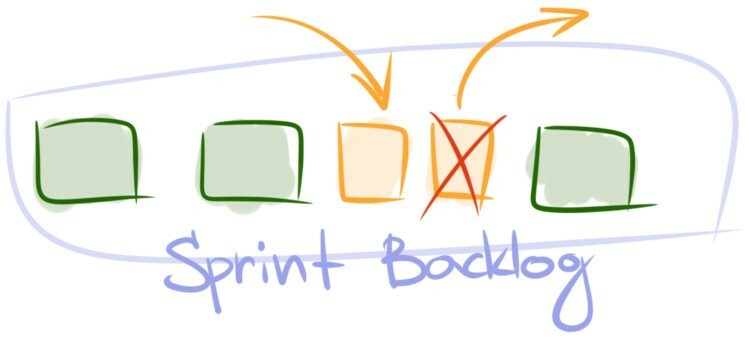
Что делать. Добавить новую историю или ошибку в спринт. Затем решить, какую другую историю или истории того же размера можно принести в жертву, и убрать их из спринта. Убранные элементы можно поместить в начало бэклога или сразу запланировать на следующий спринт.
Когда применять. Использовать эту стратегию довольно просто. Когда нужно вставить достаточно большой кусок работы, уберите из спринта что-то такого же размера. Можно спросить, что значит «достаточно большой». Product Owner этого не знает. Решение принимает команда разработки.
Область применения. Текущий и несколько следующих спринтов.
Тип действия. Действие на месте.
Затраты и риски. Замещённая история, по всей видимости, не будет поставлена в том спринте, на который планировалась. Как и в случае с «Разделить и перенести», может понадобиться дополнительная работа со стейкхолдерами.
4. Заложить буфер
Пример 4.1. Команда спланировала спринт и приступила к разработке. Через несколько дней пользователь сообщает об ошибке с высоким приоритетом. Команда заменяет запланированную историю этой ошибкой и продолжает работу. Ещё через несколько дней находят ещё пару ошибок. Ситуация повторяется несколько раз, и значительная часть бэклога спринта так и не поставляется. На следующей ретроспективе команда понимает, что уже несколько спринтов всё идёт так же.
Пример 4.2. Команда давно отвечает за бэкенд-систему и стала центром экспертизы по всем вопросам, связанным с бэкендом. Неудивительно, что с началом каждого нового спринта на команду обрушиваются просьбы о помощи от других команд.
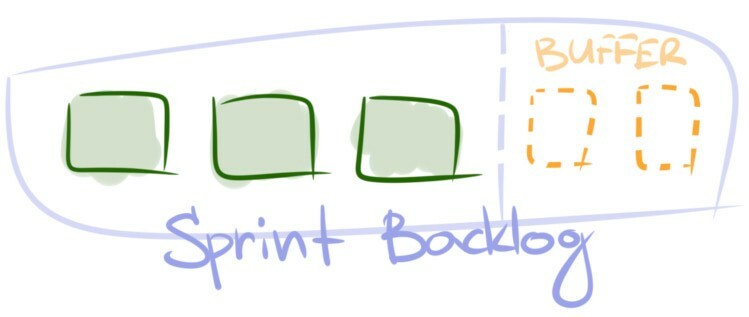
Что делать. При планировании спринта зарезервировать буфер в бэклоге спринта. Это можно сделать двумя способами. Во-первых, запланировать виртуальный элемент бэклога определённого размера, который будет засчитываться в скорость. Это и есть ваш буфер. Каждый раз, когда в спринт попадает новая история или ошибка, вы вычитаете её размер из буферного элемента, пока он не достигнет нуля. С этого момента команда отклоняет всю новую работу и отправляет её в бэклог продукта. Во-вторых, можно просто запланировать меньше элементов, чем обычная скорость спринта. В течение спринта вы просто поглощаете новые истории. Разница между средней и прогнозной скоростью будет работать как неявный буфер.
Когда применять. Попробуйте буфер, когда ситуация повторяется, незапланированная работа неизбежна по своей природе, а размер незапланированных историй значителен. Возможные примеры: у команды уникальная экспертиза, и она вынуждена консультировать другие команды; колебания рынка мешают строить надёжные прогнозы даже на пару недель. Практическое правило: буфер не должен занимать более 20–30 % скорости команды, и при этом цели спринта должны оставаться достижимыми.
Область применения. Жизненный цикл продукта.
Тип действия. Быстрое решение. Временное решение.
Затраты и риски. Очевидно, темп поставки элементов дорожной карты снизится пропорционально размеру буфера. Само по себе это может не быть проблемой, но у этого подхода есть тёмная сторона. Неожиданная работа часто возникает из-за организационных или технических неэффективностей: зависимостей между командами, унаследованного кода, низкого качества продукта. Вводя буферы, мы фактически тратим до трети собственного времени на тушение пожаров вместо создания ценности и устранения реальных проблем. Поэтому эту стратегию всегда стоит считать быстрым решением. Ещё одна причина быть осторожным с буферами: их трудно поддерживать, особенно если вы решите планировать размер. Планирование размера буфера опирается на неявное допущение, что команда сможет контролировать спрос, когда буфер дойдёт до нуля. В реальности я ни разу не видел команду, которая эффективно справлялась бы с давлением срочной незапланированной работы после переполнения буфера. Фактически вместо прогноза одной сильно колеблющейся величины — скорости спринта — теперь нужно прогнозировать две. Поэтому во многих случаях «Заменить» — лучший вариант действия на месте. Но если вы нацелены на долгосрочное решение, всегда ищите способы применить действия по непрерывному улучшению из списка ниже.
Действия по непрерывному улучшению
Стратегии этой группы требуют серьёзных усилий и много времени, чтобы принести результат. Они направлены на фундаментальные дисфункции в процессе разработки команды. Их объединяет то, что лучше всего они подходят, когда незапланированной работы много, ситуация повторяется, постоянно ломает поток команды и мешает выполнению спринтов.
5. Улучшить приоритизацию
Пример 5.1. Команда завершает планирование спринта. Через три дня после начала спринта Product Owner внезапно приходит к команде с целой кучей новых историй. Она говорит, что приоритеты неожиданно изменились. К концу спринта команда понимает, что ей нечего поставлять.
Пример 5.2. Через пару дней после начала спринта Product Owner просит включить в спринт одну историю. Какой-то стейкхолдер попросил срочно её реализовать. Ещё через пару дней Product Owner приходит с похожей просьбой. На этот раз это другой стейкхолдер, но история так же срочна, как и первая. Так повторяется несколько раз за спринт. Результат не удивляет: к концу спринта команда выполнила лишь половину своей обычной скорости.
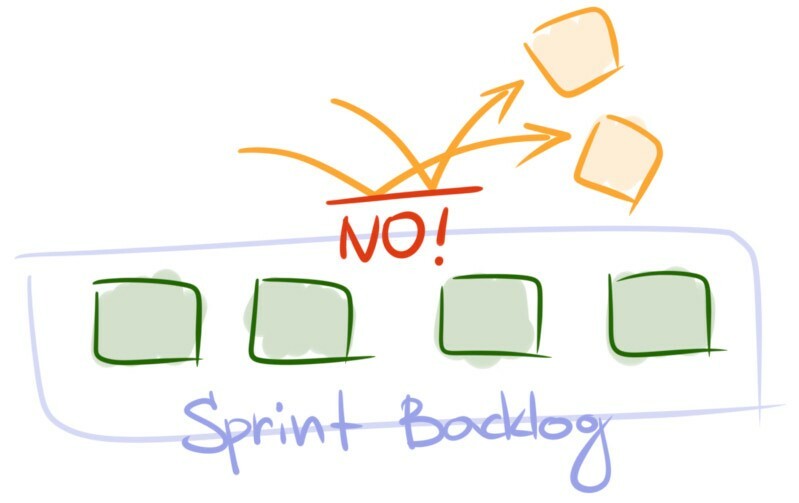
Что делать. Поработать с Product Owner, чтобы помочь ей научиться говорить «нет». Поработать со стейкхолдерами, чтобы выстроить правильные ожидания по поставке. Объяснить, что команда может принимать срочные элементы лишь изредка. При необходимости договориться, что такое срочный элемент и как часто команда может с ними справляться.
Когда применять. Примеры могут быть разными, но общая черта в том, что почти все они исходят от Product Owner или стейкхолдеров. Затем, после выполнения новых элементов, они простаивают и ждут, пока произойдёт что-то ещё. Например, пока другая команда завершит свои истории, чтобы более крупная функция стала пригодной для рынка. В реальности новые элементы чаще всего не так срочны и вполне могут подождать до следующего спринта.
Область применения. Жизненный цикл продукта.
Тип действия. Устранение первопричины.
Затраты и риски. Требуется коучинг Product Owner и переговоры со стейкхолдерами. Это может быть непростой задачей. Поскольку речь об изменении поведения людей, не ждите быстрых результатов.
6. Повысить качество
Пример 6.1. Команда получает множество сообщений об ошибках за спринт. Многие из них кажутся критическими и требуют немедленного исправления. На ретроспективе команда осознаёт, что так происходит снова и снова на протяжении нескольких спринтов. Ошибки стали серьёзной помехой. Они нарушают поток команды и влияют на поставку. Это хорошо видно на диаграммах сгорания и скорости. Спринты кажутся хаотичными. Команда теряет ощущение контроля над тем, что делает.
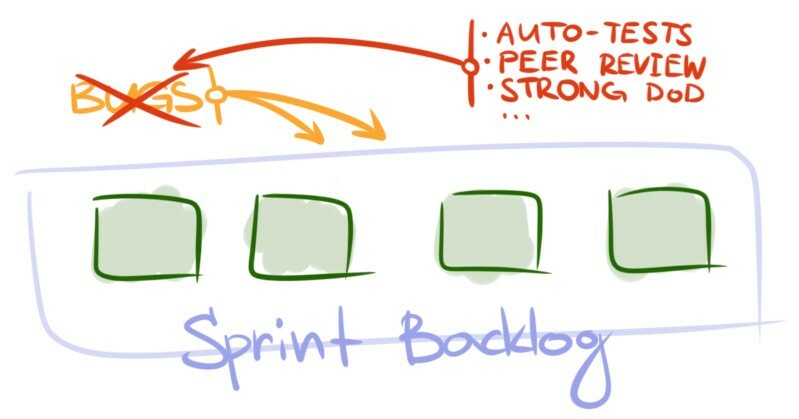
Что делать. Проанализировать причины низкого качества (например, с помощью причинно-следственных диаграмм). Не в том ли дело, что команда испытывает слишком сильное давление со стороны бизнеса и режет углы где только можно, чтобы уложиться в сроки? Не в том ли, что автоматические тесты дают недостаточное покрытие? Или, возможно, проблема в инфраструктуре, из-за которой приложение время от времени падает? Когда источники выявлены, инвестируйте время в их устранение. Пробуйте разные стратегии. Скорее всего, единого источника ошибок нет, и для решения проблемы понадобятся разные подходы.
Когда применять. Заметить, что виновато качество, нетрудно. Вы начнёте видеть, что критические ошибки появляются в спринтах всё чаще. Они будут ломать поток и делать достижение цели спринта почти невозможным.
Область применения. Жизненный цикл продукта.
Тип действия. Устранение первопричины.
Затраты и риски. Найти источник дефектов может быть непросто. Ещё сложнее реализовать исправляющие действия. Если команда наблюдает приток дефектов, достаточно мощный, чтобы нарушать поток, значит, прошло уже достаточно времени для накопления негативных последствий плохих решений. Чтобы исправить ситуацию, понадобятся серьёзные усилия. Поставка замедлится, иногда драматически. На этом этапе команде придётся пойти на компромисс. Хотят ли они исправить проблему и вернуть продукт в поддерживаемое состояние за счёт скорости? Или рискнут и понадеются, что смогут держать дефекты под контролем до конца жизненного цикла продукта? Если команда выбирает второй вариант, ей придётся вернуться к «Заложить буфер». Но помните: замедление из-за плохого качества может превысить замедление из-за его исправления гораздо раньше, чем ожидается.
7. Устранить зависимость
Пример 7.1. Как и в примере 4.2, экспертная команда владеет бэкенд-системой. Есть нижестоящая команда, которая недавно начала разрабатывать новый микросервис. Этот микросервис использует бэкенд как источник данных. Довольно быстро они понимают, что в бэкенде не хватает многих нужных им данных. Просьбы реализовать ещё один эндпоинт или добавить ещё одно поле в сущность становятся слишком частыми и начинают заметно отвлекать экспертную команду.
Пример 7.2. Команда отвечает за инфраструктуру системы. Её постоянно прерывают другие команды. Типичная просьба — обновить настройки подсистемы и пересобрать приложение. Такие задачи довольно просты, но отнимают время, и их много.
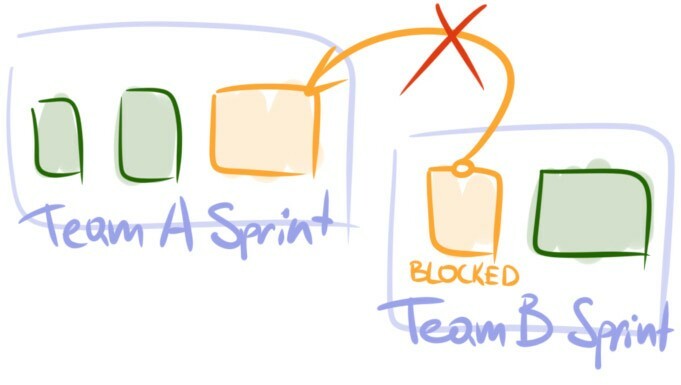
Что делать. Во-первых, нужно, чтобы зависимая команда как можно больше владела своим участком работы. Дайте ей все необходимые права и доступ к общей кодовой базе. Делегируйте ответственность и принятие решений. Например, позвольте ей самой развёртывать подсистему, которой она управляет, вместо того чтобы оставлять это право за отдельной инфраструктурной командой. Обучите людей разрабатывать в общей кодовой базе и выполнять делегированные действия. Настройте процесс код-ревью, чтобы избежать падения качества кода. Разработчик из экспертной команды может на время присоединиться к зависимой команде, чтобы быстро поднять её экспертизу и уменьшить потребность в код-ревью между командами. Во-вторых, ищите технологические способы разорвать зависимость между двумя командами. Без этого многие из перечисленных шагов невозможны. Впрочем, даже разделение подсистем само по себе может помочь командам стать самостоятельнее. Например, в примере 7.2 зависимая команда может перенести часть настроек с этапа сборки на этап выполнения. В итоге она сможет тонко настраивать приложение сама, без участия инфраструктурной команды.
Когда применять. Как следует из названия, эта стратегия подходит, когда незапланированная работа приходит в виде запросов от нижестоящей команды. Как правило, эти запросы блокируют команду, которая их создаёт.
Область применения. Жизненный цикл продукта.
Тип действия. Устранение первопричины.
Затраты и риски. Обеим командам придётся приложить усилия, чтобы устранить зависимость. Это включает сессии передачи знаний и обучение, изучение новой кодовой базы и реализацию технологических улучшений. Перевод участника из одной команды в другую также требует времени, чтобы обе команды привыкли к новому составу. Это может повлиять на скорость обеих команд. Кроме того, поскольку любые изменения в структуре команды могут запустить процесс перестройки, всегда есть риск вызвать конфликт, требующий особого внимания.
8. Адаптировать процесс
Пример 8.1. Команду постоянно прерывают во время спринтов. Цели спринта устаревают, и бэклоги спринтов полностью перекраиваются по нескольку раз за спринт. Незапланированная работа в основном приходит от Product Owner. Тщательный анализ приводит команду к пониманию, что она ничего не может с этим сделать. Дело в том, что команда разрабатывает продукт в молодой отрасли с жёсткой конкуренцией. Задержка критической функции даже на несколько дней может выбить компанию из бизнеса.
Пример 8.2. Команда работает над долгоживущим продуктом с огромной унаследованной кодовой базой. Она испробовала все известные хорошие практики и усердно работает над улучшениями. Несмотря на все усилия, объём технического долга и масштаб продукта делают почти невозможным завершить в спринте даже самую маленькую историю. Проблема лежит за пределами досягаемости команды. Её эскалировали не раз и запустили специальную инициативу для решения. Некоторые положительные эффекты уже заметны, но прогресс слишком медленный. Команда понимает, что за одну ночь ситуация не улучшится. Нужно как-то справляться с тем, что есть.
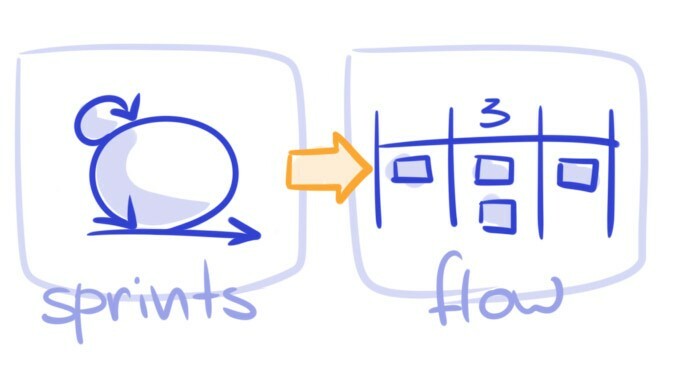
Что делать. Попробовать что-то другое. Отказаться от итераций и начать использовать метод Kanban. Спринты — не единственный способ вести разработку. Дополнение: как советовали в комментариях, можно попробовать спринты покороче, прежде чем переходить на полноценный Kanban, или выбрать собственный вариант. В целом — адаптироваться к процессу, лучше всего подходящему в вашем контексте.
Когда применять. Главный фокус этой стратегии — адаптация к объективной реальности. Применяйте её, когда незапланированная работа неизбежна по своей природе и продиктована внешними условиями, которые вы не контролируете. Однако есть оговорка. В идеале менять процесс стоит лишь тогда, когда вы хотите либо адаптироваться к рынку, либо получить рычаг влияния на рынок. В реальной жизни всегда есть множество факторов, и выбор в пользу «Адаптировать процесс» всё равно может быть оправдан. Вы можете решить применить эту стратегию в ситуации, подобной примеру 8.2. Но нужно понимать, что это временная мера, которая поможет снять лишнюю нагрузку с людей и выиграть время для реальных улучшений.
Область применения. Жизненный цикл продукта или временно, в зависимости от цели.
Тип действия. Устранение первопричины.
Перспектива. Обход первопричины.
Затраты и риски. Не случайно эта стратегия стоит последней. Хотя она может оказаться настоящим решением для вас, применять её нужно осторожно и осознанно. Вы должны быть абсолютно уверены, что перемены диктуют именно внешние обстоятельства. Не попадайтесь в ловушку, принимая собственные проблемы за объективные обстоятельства. Помните, что применение этой стратегии всегда затратно и может быть рискованным, так как помещает команду в новый контекст и может запустить перестройку. Производительность команды, скорее всего, снизится, и потребуется время, чтобы привыкнуть к новому способу работы. Поэтому, прежде чем пытаться изменить процесс, всегда проведите тщательный анализ ситуации и попробуйте другие стратегии из этого списка. Иначе вы рискуете лишь замаскировать существующие проблемы, не решив настоящую.