Стратегии работы с багами во время спринта
Ещё одна неожиданно популярная тема, которая многих путает. Что делать, когда во время итерации нашли баг? Чинить сразу или отложить? Трекать на доске задач или не стоит тратить время? Ответ на самом деле несложный. Давайте разберём.
По сути есть только три способа обработать только что найденный баг:
- починить сейчас,
- починить позже,
- игнорировать.
Какую стратегию выбрать, почти полностью зависит от двух вещей: критичности бага и ожидаемого времени на фикс. Разберём каждую стратегию.
Починить сейчас
Что делать. Починить сразу в рамках текущего спринта.
Когда применять. Стратегия разумна в одном из двух случаев: баг чинится быстро — тогда проще и дешевле починить сразу; или он критичен — тогда выбора почти нет.
Как трекать. Много вопросов именно о том, как трекать non-production баги, найденные во время активной разработки user story. Способов много, самый простой — не трекать вовсе. Лучше всего работает для мелких багов, которые чинятся за пару часов, и позволяет избежать лишней бюрократии.
Но это не всегда лучший вариант. В большинстве случаев баг всё же стоит визуализировать: он блокирует user story, а блокеры нужно видеть на доске. Есть несколько вариантов.
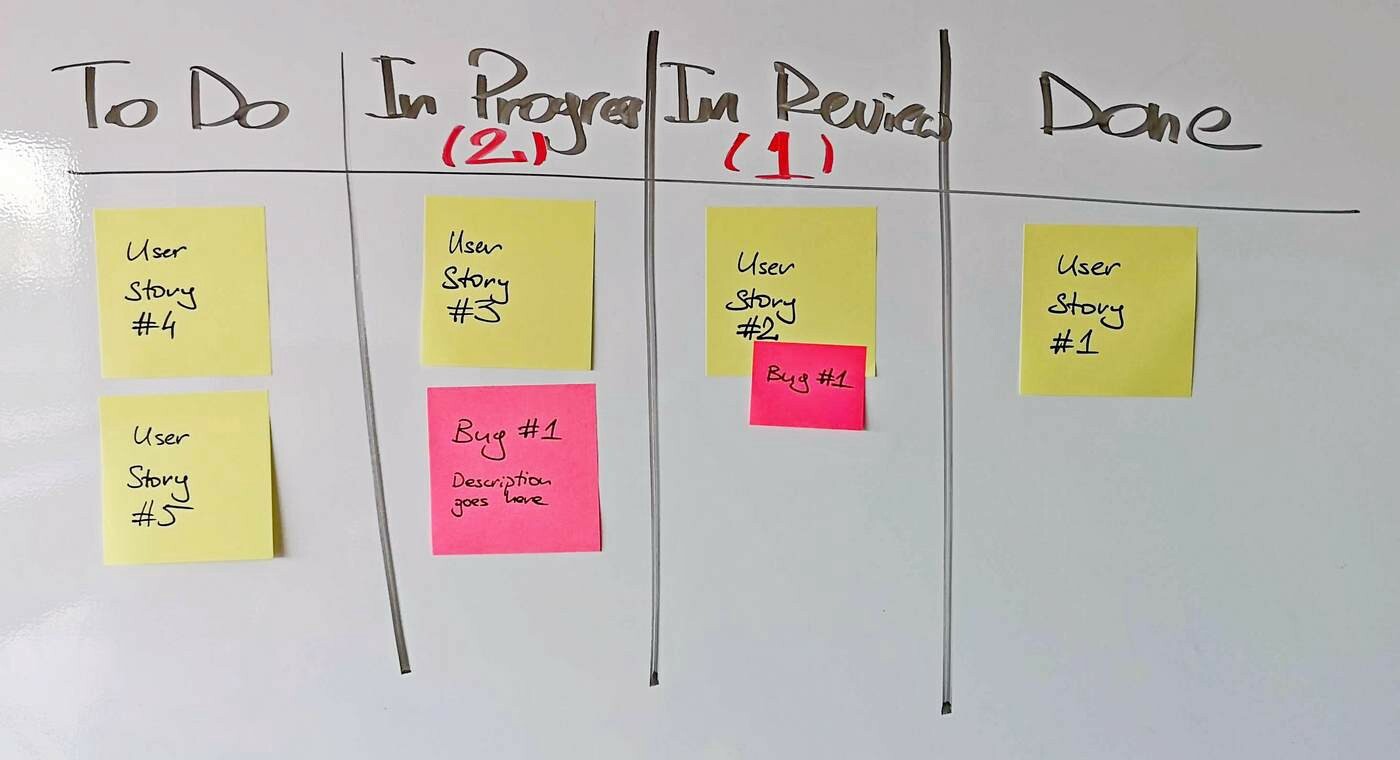
На физической доске типичный подход — красный стикер поверх карточки in progress. Это может быть большой лист с доп. информацией или маленький красный стикер. Если хотите учитывать баг в WIP-лимитах (если они есть), можно добавить отдельную карточку вместе с красным стикером. Она займёт место на доске и пойдёт в лимит колонки — так команда сильнее мотивирована починить баг.
Если инструмент цифровой, варианты сильно зависят от софта. Возьмём Jira. Лучше всего у меня работал отдельный тип issue Sub-bug (название не важно) — ещё одна версия Sub-task. Полезно также flagged story для более заметной визуализации — аналог красного стикера на физической доске. Создать полноценный Bug тоже можно, с той же логикой, что и в примере с физической доской.

Починить позже
Что делать. Создать новый элемент бэклога и положить в product backlog. Дальше баг планируется в будущие итерации как любой другой элемент.
Когда применять. Иногда баг критичен, но недостаточно, чтобы чинить прямо сейчас — особенно если кажется большим. Это относится и к production, и к багам, найденным при активной разработке story.
Как трекать. Создать новую карточку и положить в бэклог. Если есть отдельные типы для багов (обычно есть) — используйте их. На физической доске типичны красные стикеры для багов; в Jira по умолчанию есть тип Bug или Defect.
Игнорировать
Что делать. Ну… ничего.
Когда применять. Иногда баг вообще не стоит трогать: кажется относительно сложным в фиксе, а ущерб от нефикса мизерный. Вы принимаете риск с мыслью: если важно — баг сообщат снова.
Как трекать. Не трекаете. Если уже какое-то время работали над багом и есть карточка — просто уберите её с доски.
Production и non-production баги
На первый взгляд production и non-production баги разные. Но если подумать — разница не так велика. Если баг мелкий или крайне критичный — лучше чинить на месте, независимо от того, когда поймали. Если слишком большой для починить сейчас — в бэклог, снова независимо от тайминга. В остальных случаях просто не тратите время. Разница — в том, как вы оцениваете критичность. Для production вы чаще склоняетесь к починить позже: они обычно больше и требуют больше работы. Для non-production в большинстве случаев логичнее починить сейчас, пока контекст свежий.